Die meisten KI-Funktionen (Künstliche Intelligenz) lassen sich nur online nutzen – etwa ChatGPT, Google Gemini (ehemals Bard) und viele weitere. Aber inzwischen gibt es auch so einige Open-Source-KIs – sogenannte LLMs, etwa die von Facebook – llama2. Solche lassen sich auch lokal nutzen – und, natürlich auch unter Linux, ganz einfach installieren mit Ollama.
Ollama installieren
Sie finden das Script zur Installation unter Ollama zum Download – einfacher gelingt dies als root auf dem Terminal mit dem Befehl:
curl -fsSL https://ollama.com/install.sh | shHaben Sie nur sudo – starten Sie den Befehl als normaler Benutzer. Ein kleiner Tipp: Finden Sie solche Befehle auf nicht offiziellen Seiten, so laden Sie das Script erst nur herunter und sehen es sich erst einmal an, bevor Sie es starten 😁:

Haben Sie keine NVIDIA im Computer eingebaut, wird die KI später etwas träge sein – außer die CPU gibt ein wenig her.
Installiert wird die Software übrigens unter „/usr/local/bin“ – ein
rm /usr/local/bin/ollamaals root am Terminal lässt die Software wieder verschwinden.
KIs mit Ollama installieren
Ollama ist nur die Software, mit der Sie KI-Sprachmodelle installieren und ausführen. Also gilt es, erst einmal sie zu installieren. Ollama läuft nach der Installation automatisch – dies zeigt die Adresse:
localhost:11434Im Webbrowser:
Dies muss natürlich nicht sein, Sie können die Software über Systemd steuern – also als root auf dem Terminal:
systemctl status ollama.service
systemctl diasble --now ollama.service
systemctl start ollama.service
systemctl stop ollama.service
systemctl enable --now ollama.service
Noch können Sie über die Software am Terminal keine KIs suchen – Sie müssen sich noch auf die Webseite bemühen – Ollama-KIs.
Mit:
ollama pull KIinstallieren Sie anschließend die gewünschte KI – gleich ein Versuch:
ollama pull llama2Dies gelingt als normaler Benutzer:

Im Fall von llama2 sind dies rund 3,8 GB. Die heruntergeladene KI gilt es jetzt über Ollama zu starten, hierzu dient die Syntax:
ollama run modellIn meinem Beispiel also:
ollama run llama2Schon wartet die KI auf Anfragen:
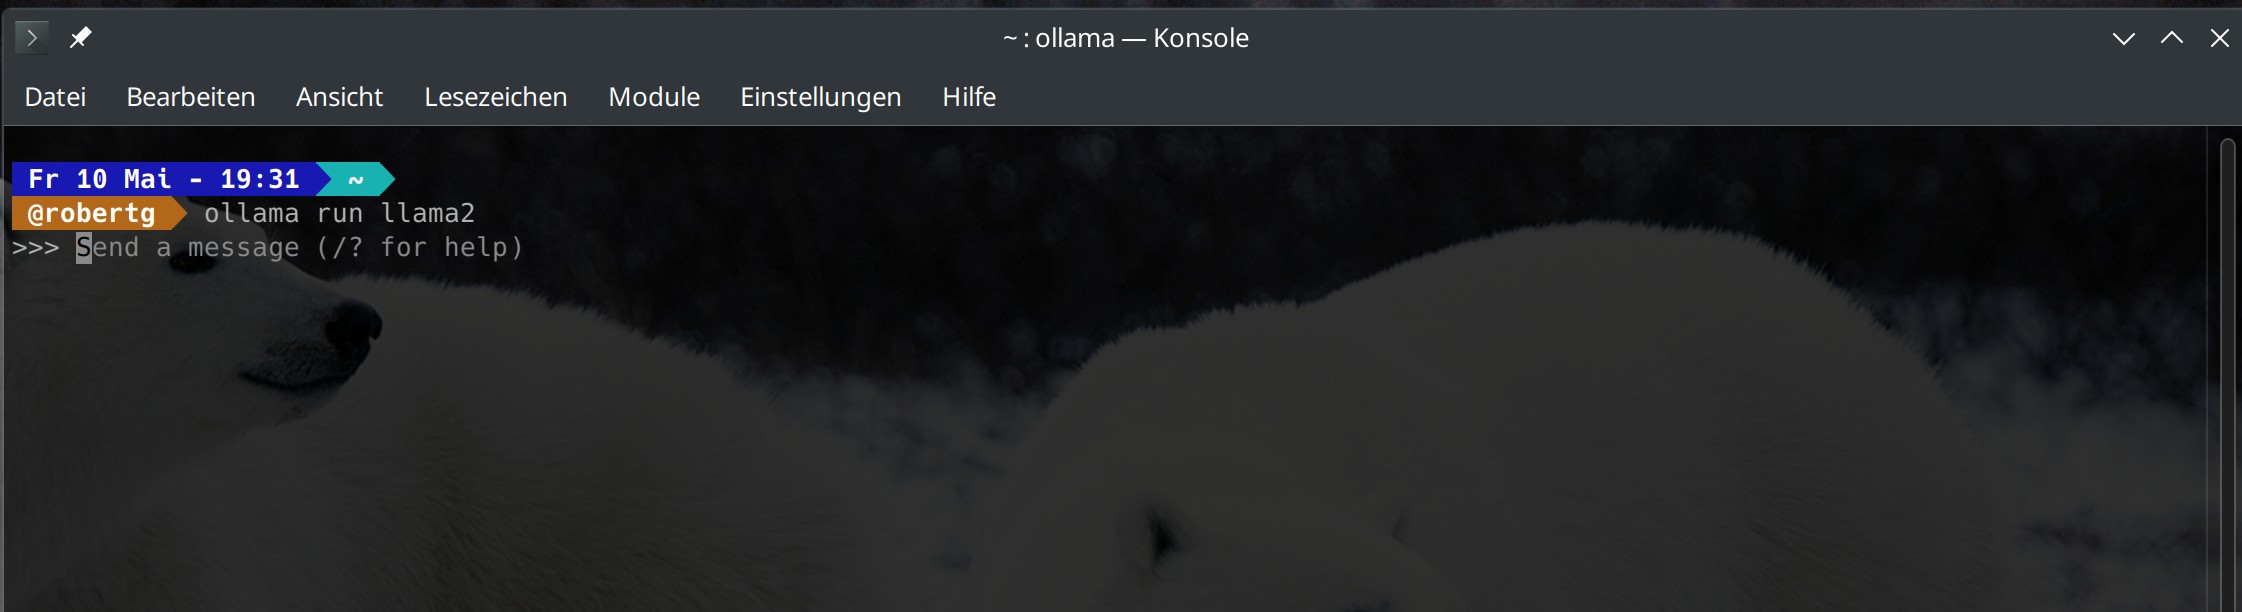
Meine erste dumme Frage: „Was ist Linux?“ Die Software antwortet auf diese Frage in Deutsch zwar auf Englisch, dies ist kein Problem. Ich dachte eigentlich, dass die Software ohne NVIDIA-Grafikkarte Probleme machen würde, aber hier, mit einer Intel-GPU am Laptop, kein Problem – nicht langsamer als etwa ChatGPT im Webbrowser:

Nicht mal der Lüfter hat zu arbeiten begonnen. Mit /? lässt sich unter llama2 etwa die Hilfe anzeigen, mit Strg+d oder /bye beenden Sie die KI – Ollama läuft aber weiter – siehe Systemd oben.
Installierte KIs lassen Sie sich mit:
ollama listanzeigen:
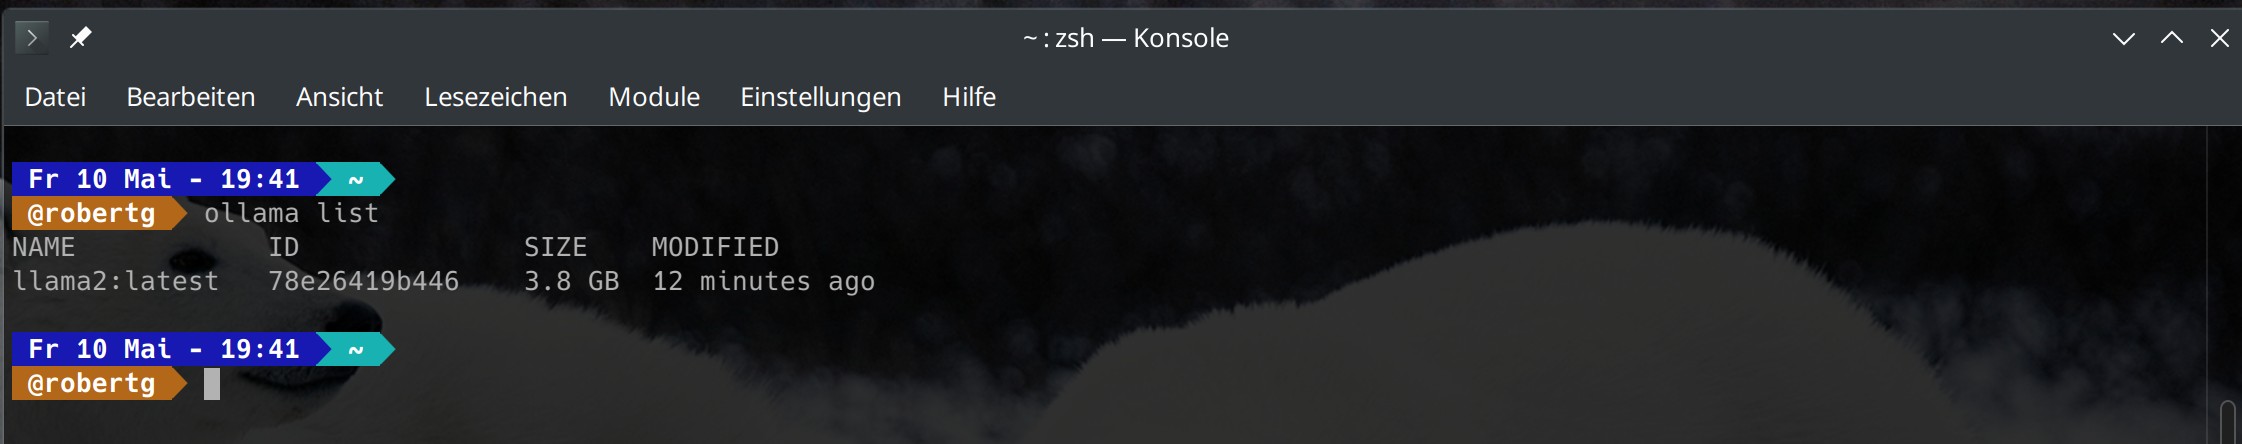
Mit:
ollama rm modellentfernen Sie eine KI wieder aus dem System – etwa:
ollama rm llama2Weiteres
Wichtig – bevor Sie Ollama wie oben beschrieben deinstallieren, deaktivieren Sie den Service. Sie können Ollama auch mit der grafischen Oberfläche Open WebUI nutzen.


4 Reaktionen
[…] Ollama lässt sich auch mit grafischer Oberfläche unter Linux nutzen, die Software nennt sich Open WebUI. Zur Installation nutzen Sie Docker oder Podman. Ollama installieren Sie wie am ersten Link und lassen es via Systemd laufen. […]
Danke, hab gleich einen passenden Artikel erstellt und als Link angefügt 🙂
In dieser schönen Anleitung fehlt noch ein Hinweise auf Speicherplatzanforderungen. Beim Start wird mir gemeldet: Error: model requires more system memory (8.4 GiB) than is available (7.2 GiB)
[…] Sie bereits Ollama installiert, können Sie dies weglassen. Ich beschreibe die Installation hier unter auf Debian […]