Recoll ist eine leistungsstarke, quelloffene Volltextsuchmaschine für Linux, die Dokumente nicht nur nach Dateinamen, sondern nach ihrem tatsächlichen Inhalt durchsucht. Das Tool indexiert Texte in PDFs, Office-Dokumenten, E-Mails, Archiven und zahlreichen weiteren Formaten und macht sie mit einem Klick auffindbar – unabhängig vom Speicherort.
Das Tool basiert auf der bewährten Xapian-Suchbibliothek und bietet eine grafische Qt-Oberfläche, die auch Einsteigern den Einstieg erleichtert. Das Programm extrahiert Text aus unterstützten Dokumentformaten, legt einen durchsuchbaren Index an und ermöglicht komplexe Suchanfragen mit Booleschen Operatoren, Phrasensuche und Feldfiltern.
Installation unter Linux
Recoll steht für die meisten Distributionen in den offiziellen Paketquellen bereit. Für Debian installieren Sie Recoll mit den erforderlichen Abhängigkeiten mit folgenden Befehl:
sudo apt update
sudo apt install recoll python3-mutagen unrtf antiword
Für Nutzer, die eine isolierte Installation bevorzugen, bietet sich ein Flatpak oder das offizielle AppImage an.
Konfiguration und Indexerstellung
Beim ersten Start schlägt Recoll vor, einen Suchindex zu erstellen. Bevor dies geschieht, empfiehlt sich eine kurze Konfiguration, um unnötige Daten auszuschließen und die Indexierung zu beschleunigen.
Index-Verzeichnisse festlegen
Über das Menü Einstellungen → Index-Einstellungen werden im Reiter Globale Parameter die zu durchsuchenden Ordner definiert. Standardmäßig ist das gesamte Home-Verzeichnis (~) eingetragen. Für eine schlankere Indexdatenbank können spezifische Ordner wie Dokumente, Downloads oder E-Mails hinzugefügt und das Home-Verzeichnis entfernt werden.
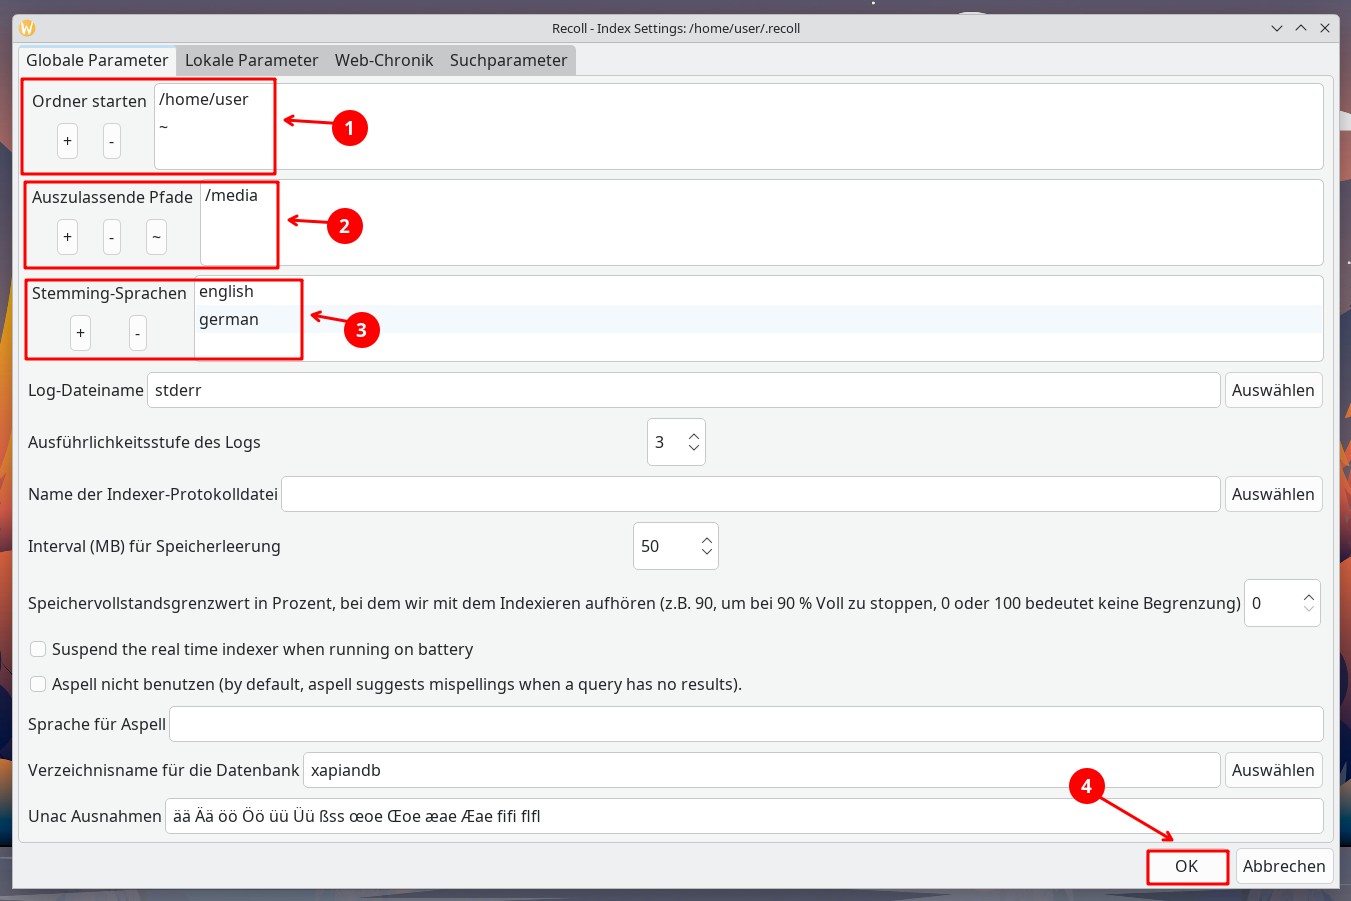
Recoll – Konfigurationseinstellungen
Im gleichen Dialog lassen sich unter Auszulassende Pfade Verzeichnisse wie .cache, node_modules oder virtuelle Laufwerke ausschließen, die keine relevanten Dokumente enthalten.
Dateitypen und Sprachen anpassen
Der Reiter Lokale Parameter erlaubt die Definition von Dateinamenmustern (zum Beispiel *.tmp, *~), die ignoriert werden sollen. Zusätzlich kann die Standardsprache für die Texterkennung festgelegt werden – wichtig für korrekte Stemming-Ergebnisse bei der Suche.
Indexierung starten
Nach Bestätigung mit OK wird über Datei → Index aktualisieren die erstmalige Vollindexierung angestoßen. Dieser Vorgang kann je nach Datenmenge mehrere Minuten dauern. Anschließend aktualisiert Recoll den Index bei Bedarf manuell oder automatisch im Hintergrund.
Für eine automatische Aktualisierung lässt sich ein Cron-Job einrichten oder der Daemon-Modus nutzen:
recollindex -m # Echtzeit-Indexierung als HintergrundprozessAnwendung im Alltag
Die Suche erfolgt über das Eingabefeld in der Hauptoberfläche. Recoll unterstützt einfache Begriffe, Phrasen in Anführungszeichen („Linux Tutorial“) und Boolesche Operatoren (AND, OR, NOT). Fortgeschrittene Nutzer filtern nach Dateityp (type:pdf), Pfad (dir:~/Dokumente) oder Metadaten.
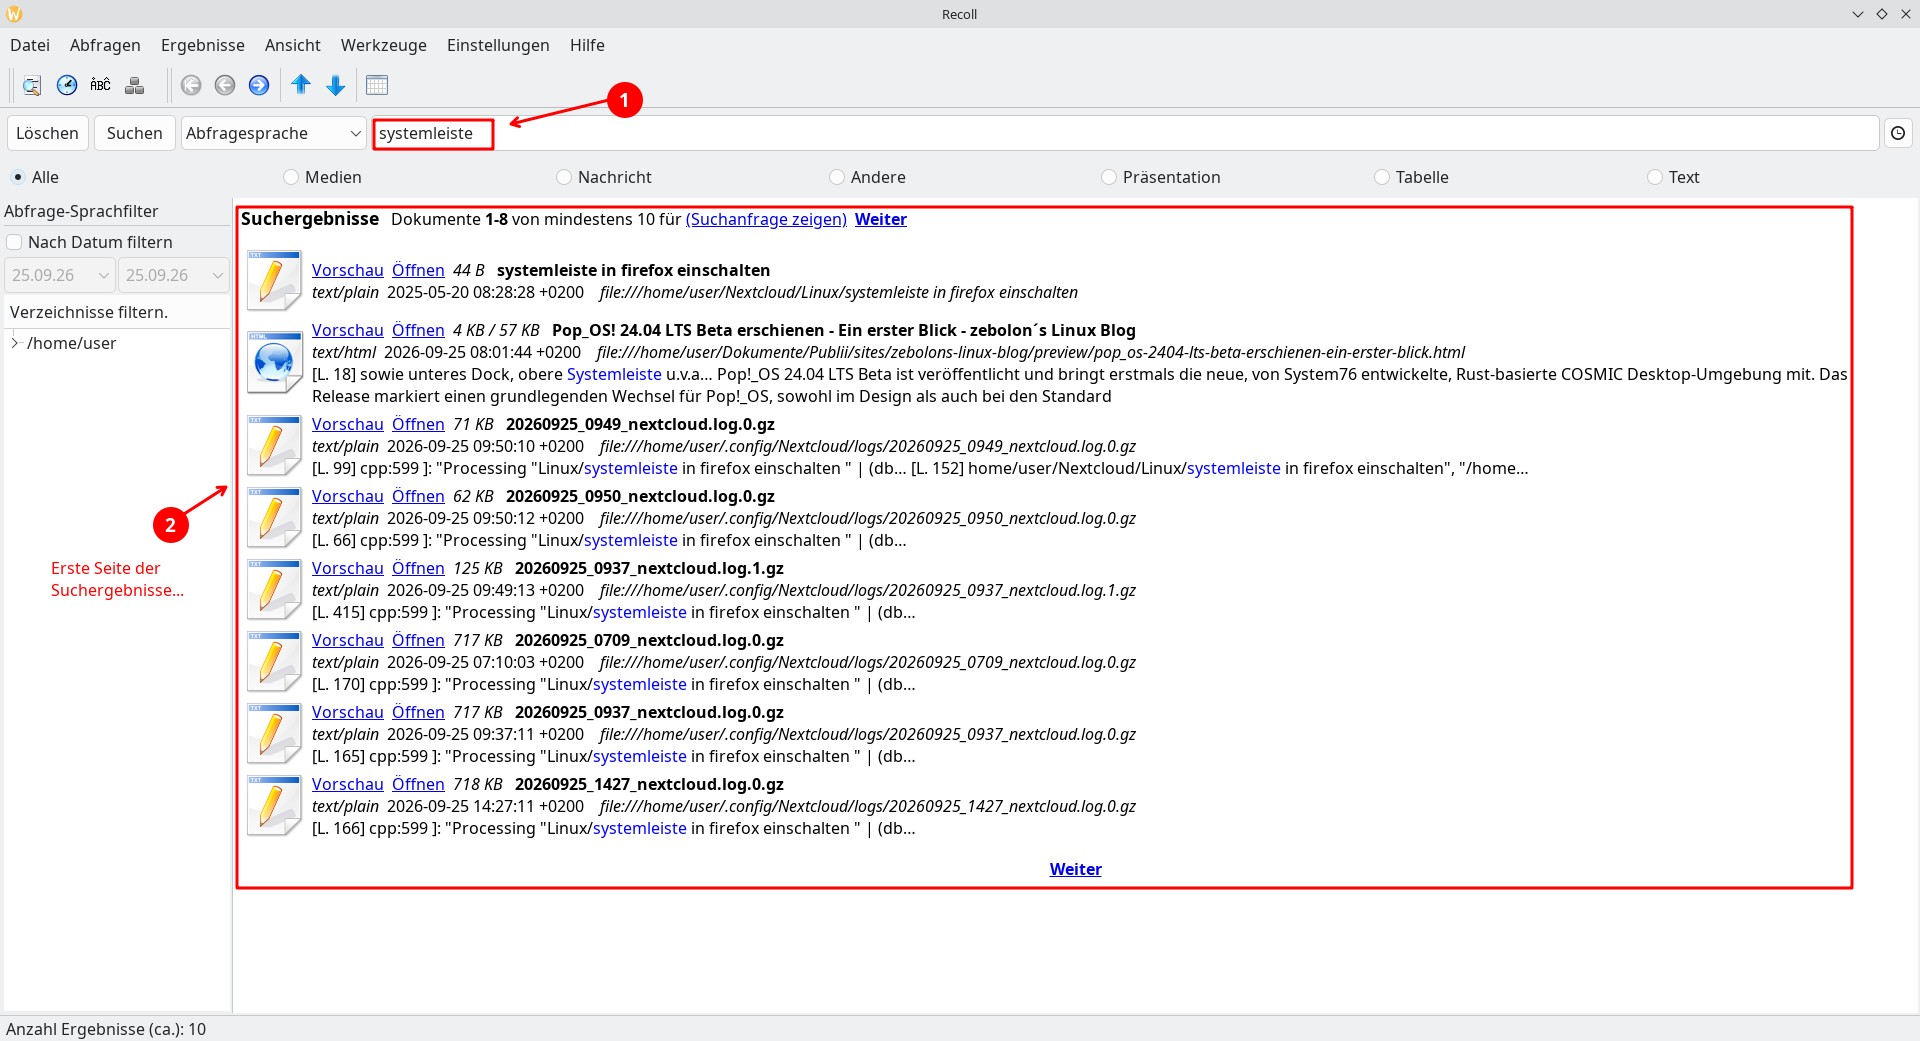
Recoll – Suchergebnisse
Jedes Suchergebnis zeigt eine Vorschau des Dokumentinhalts. Ein Doppelklick öffnet die Datei im Standardprogramm, ein Rechtsklick ermöglicht das direkte Kopieren von Textstellen. Die Suchhistorie und gespeicherte Filter beschleunigen wiederkehrende Anfragen.
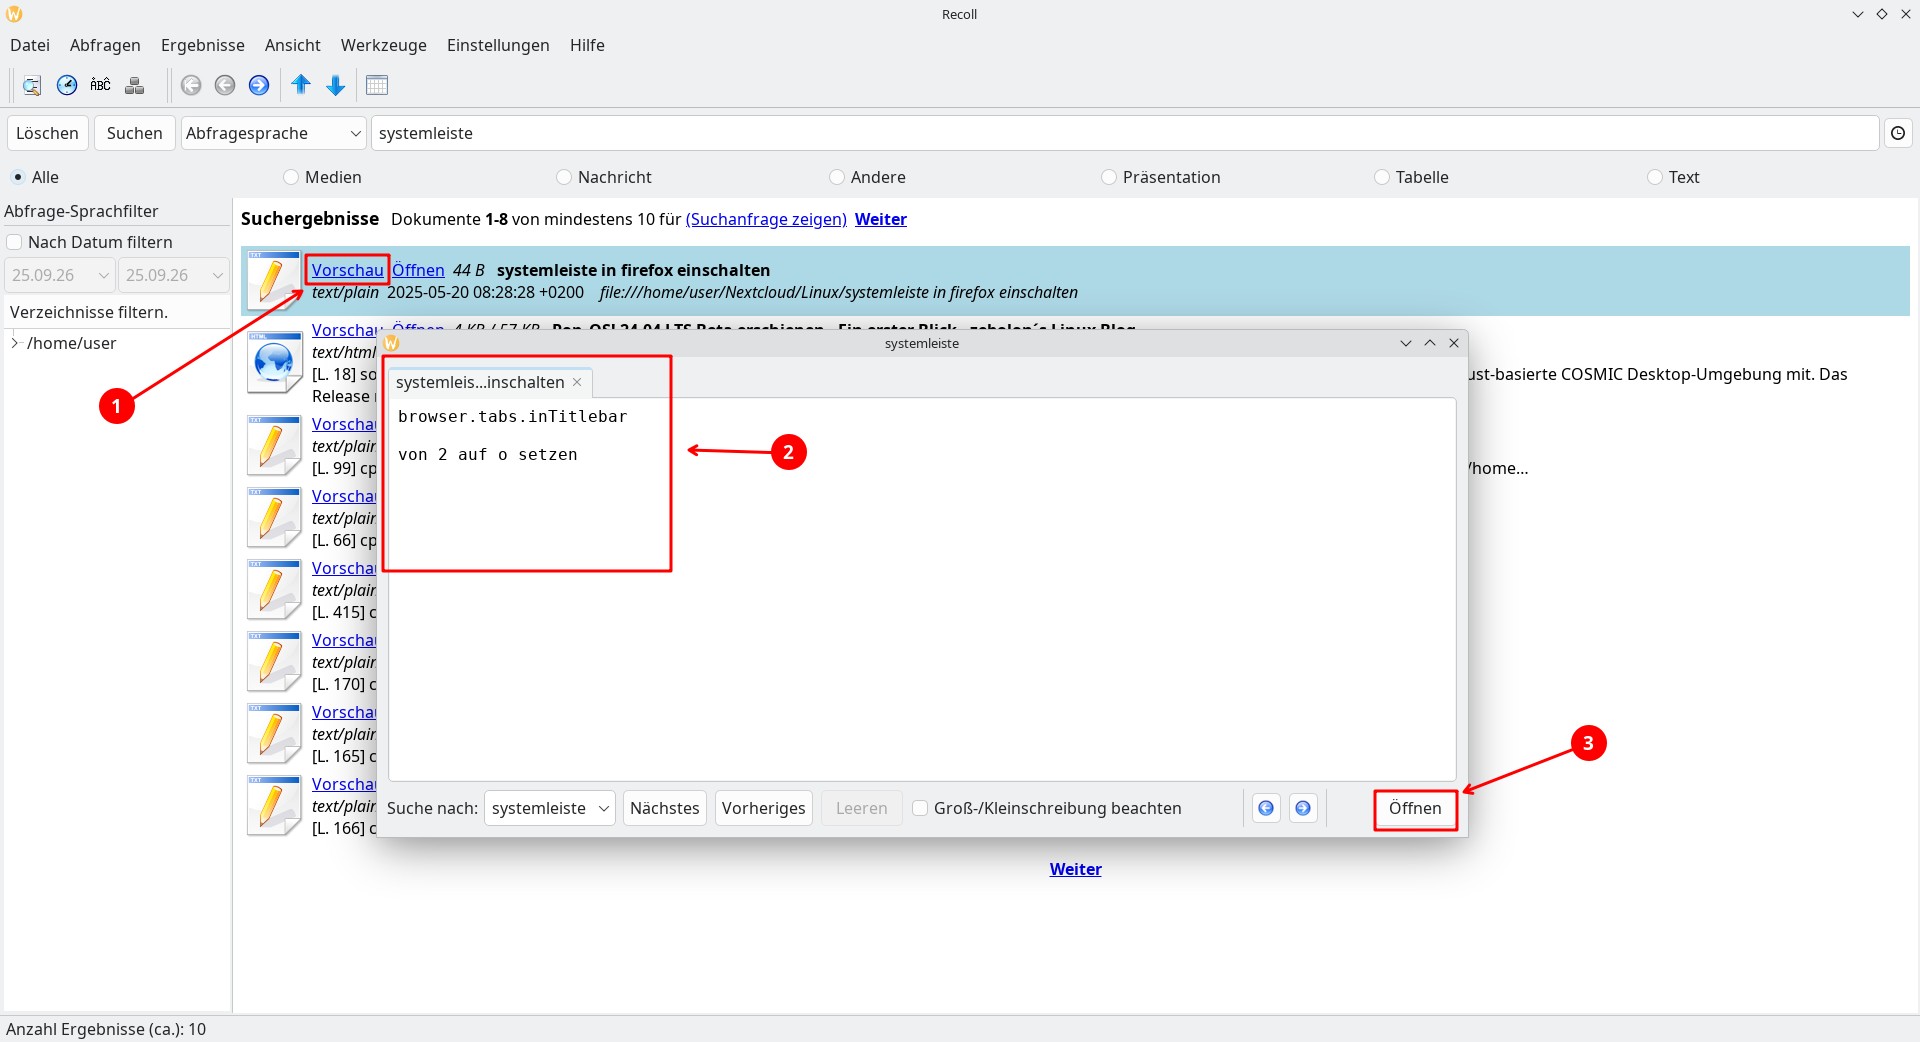
Recoll – Vorschau
Ein Klick auf Öffnen öffnet den Treffer in der Standard-Anwendung für den Datei-Typ…
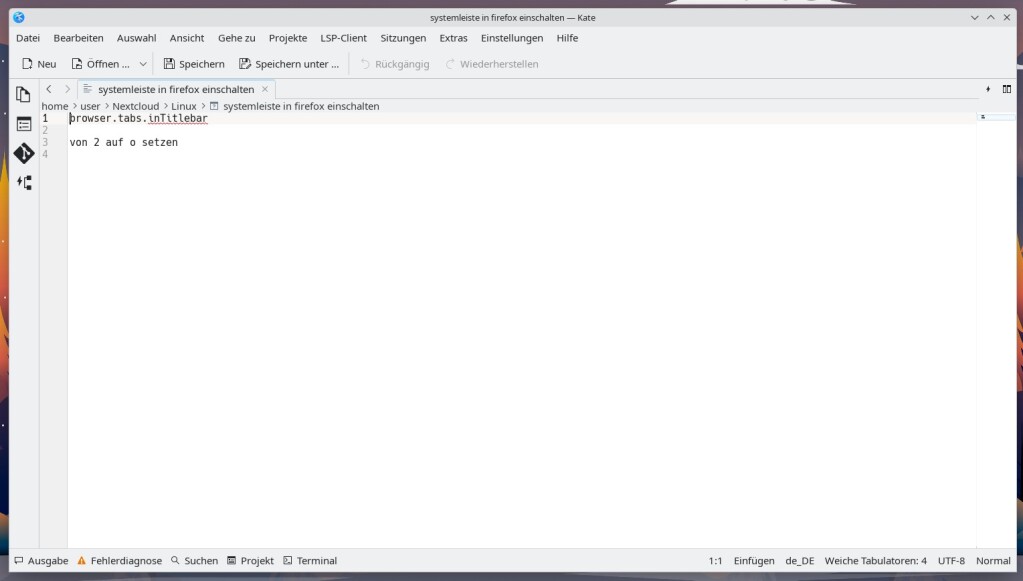
Originaldatei im Standard-Texteditor
Fazit
Recoll schließt eine wichtige Lücke im Linux-Desktop: Eine schnelle, lokale Volltextsuche, die unabhängig von Cloud-Diensten funktioniert und eine breite Palette an Dokumentformaten beherrscht. Die Installation per Flatpak oder AppImage macht das Tool distributionsunabhängig nutzbar, während die Konfiguration auch für Einsteiger nachvollziehbar bleibt.
Für Nutzer mit großen Dokumentbeständen, Archivdateien oder E-Mail-Sammlungen ist Recoll eine empfehlenswerte Ergänzung zur klassischen Dateisuche. Die Kombination aus grafischer Oberfläche, flexibler Suchsyntax und optionalem Webzugriff macht das Tool zu einer ausgereiften Lösung für den produktiven Einsatz.
Titelbild: Image by studiogstock on Magnific


5 Reaktionen
Top Software, läuft hier seit Jahren einwandfrei. Der Entwickler ist für Verbesserungsvorschläge offen, habe schon einige eingereicht und diese wurden auch umgesetzt. Wenn die Indexierung mit der Zeit langsamer wird, lasse mir die Indexierungsfehler und Zeiten morgens anzeigen, dann einfach den Index z.B. über Nacht neu aufbauen. So ’ne richtige Garbage Collextion hat die Xapian-DB leider nicht, ist mir zumindest nicht bekannt.
Garbage Collection wäre:
xapian-compact quellindex-ordner compactindex-ordner
mv compactindex-ordner/* quellindex-ordner
vorher darauf achten, dass recollindex nicht mehr läuft.
Der größte Vorteil bei Recoll: Weiß man den Dateinamen nicht mehr, genügt es einen Begriff des Dokumenten-Inhaltes einzutippen. Das Tool ist rasend schnell und hat eine Top-Vorschaufunktion…
funktioniert auch übers Netzwerk:
ssh -Xt user@server ‚QT_FONT_DPI=96 recoll‘ z.B. für mein olles Ubuntu 22.04 LTS
xapian-compact ist nach langer Laufzeit der Indexierung der Bringer, schrumpft die Index-Dateien sichtlich; die Indexierungszeit sinkt merklich.